
在公開的 xAI API 上,提示詞不到 20 萬 token 時,Grok 4.7 是每百萬輸入 token $2、快取輸入 $0.50、輸出 $6。長上下文那一列是 $4 / $1 / $12。2026 年 9 月 22 日打開的 API 價格頁 裡,這三個數字和長上下文列都與 Grok 4.6 相同。牌價沒有動。帳單還是會動。
同一則發布說明中,xAI 的 CursorBench 4.0 把一個 Grok 4.7 任務標成 Low $1.58、Extra High $6.01。費率卡一個字都沒改,單任務成本大約差 3.8 倍。一位 Cursor Ultra 使用者在 extra high、關閉 fast mode 時,把體感收成一句:“Grok 4.7 is about 2.5 times as expensive as 4.6.”(r/cursor,2026-09-21)。帳先算清楚,Tabbit 才是拿來試一條路線的地方。
先記住這幾件事
牌價與 Grok 4.6 相同。 短上下文是每百萬 token $2 / $0.50 / $6。輸入達到 20 萬 token 時,整次請求改為 $4 / $1 / $12。
真正拉開差距的是推理檔。 xAI 的 CursorBench 從 Low 到 Extra High 依序是每任務 $1.58、$3.49、$4.69、$6.01。API 預設推理檔是 high。
Fast 是第二張表,不是一句口號。 印出的 Fast 費率是 20 萬以下 $4 / $1 / $12,以上 $6 / $1.50 / $18。它只在 Cursor 與 Grok Build,不在公開 API。
Cursor 的門檻是 25.6 萬,不是 20 萬。 Cursor 模型頁在輸入超過 25.6 萬 token 後,把標準隨選費率加倍,並把 50 萬上下文的 Fast 標成 $6 / $1.50 / $18。快取寫入欄是橫線,不是單獨一筆費用。
grok-4.7 沒有 Batch 折扣。 模型頁寫明 Batch API 不支援。工具呼叫、美國端點 10%,以及生成前 $0.05 的違規費,都不在標題價裡。
費率一覽
下表單位是每百萬 token 的美元,取自 xAI 價格頁,採於 2026 年 9 月 22 日。Grok 4.6 總覽 講的是上一代模型。這張表只談錢。
| 模型 | 上下文 | 短輸入 | 短快取 | 短輸出 | 長輸入 | 長快取 | 長輸出 | 長上下文門檻 |
|---|---|---|---|---|---|---|---|---|
| grok-4.7 | 500k | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 | ≥ 20 萬 token |
| grok-4.6 | 500k | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 | ≥ 20 萬 token |
| grok-4.5 | 500k | $2.00 | $0.30 | $6.00 | $4.00 | $0.60 | $12.00 | ≥ 20 萬 token |
| grok-build-0.1 | 256k | $1.00 | $0.20 | $2.00 | $2.00 | $0.40 | $4.00 | ≥ 20 萬 token |
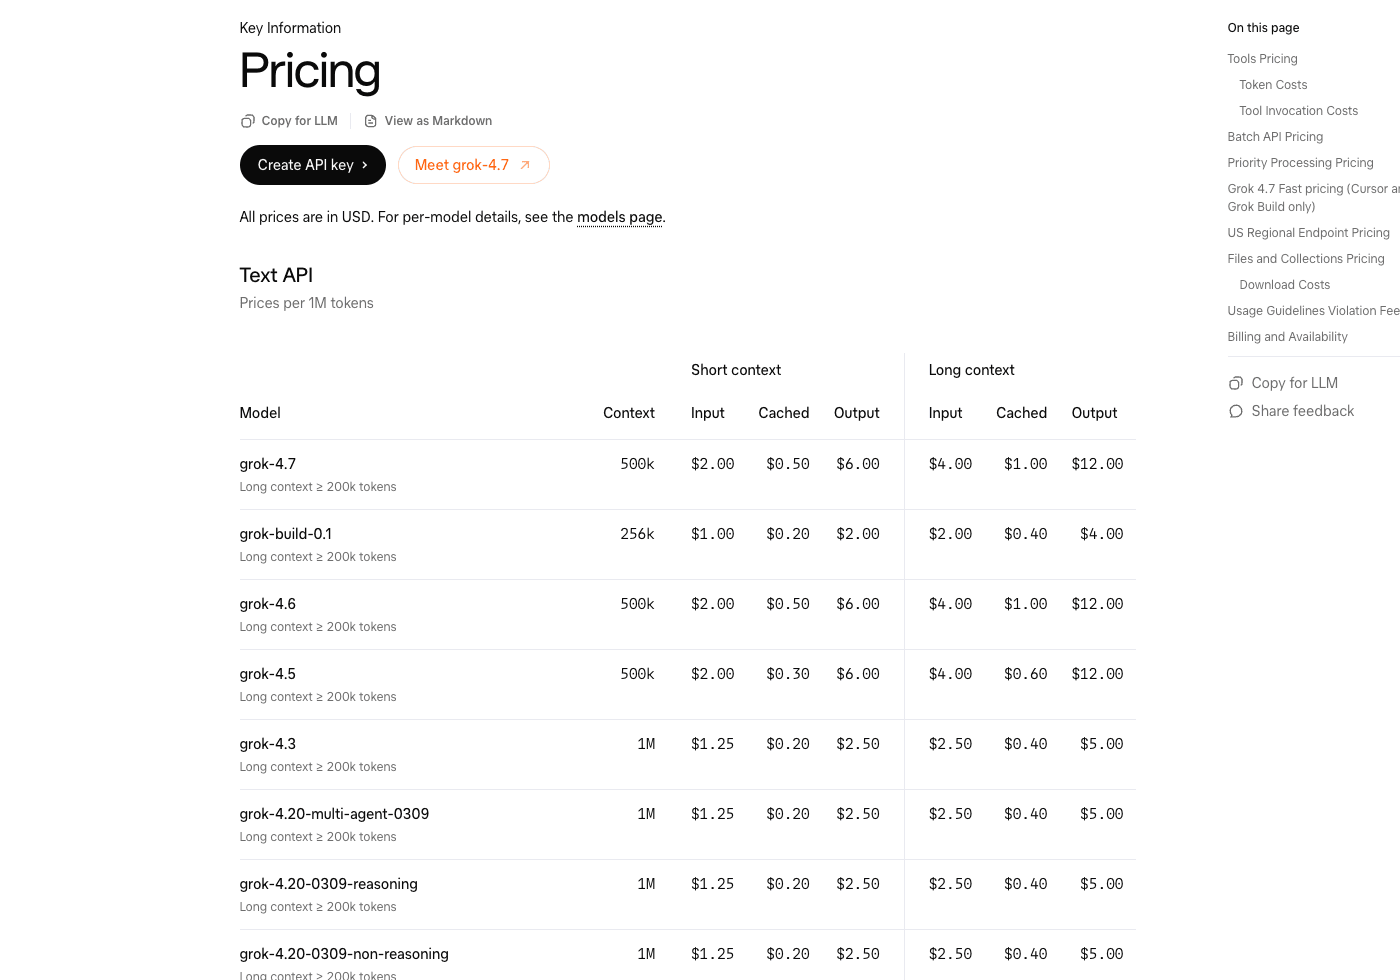
grok-4.7 的四個短上下文數字與 grok-4.6 完全一樣。價格頁寫明:有長上下文定價的模型,一旦提示詞到達門檻,該請求裡的全部 token 都按長上下文費率計。跨過 20 萬,不是只給超出的部分漲價。
模型詳情頁重複短上下文:輸入 $2.00、快取 $0.50、輸出 $6.00。打開 “Higher context pricing” 之後,數字換成 $4.00、$1.00、$12.00。上下文視窗是 50 萬。推理檔為 low、medium、high、xhigh,預設 high。Batch API 標為不支援。核對時區域是 us-east-1,該頁限額為每秒 150 個請求、每分鐘 5,000 萬 token。
一個數字:每任務 $1.58 到 $6.01
如果只留一個數,留這個跨度,而不是 $2。Grok 4.7 發布頁 寫模型 “priced starting at $2 per million input tokens and $6 per million output tokens”,並說快速變體是 “twice the output speed at twice the price”。同一頁的 CursorBench 4.0 成本視圖,2026 年 9 月 22 日從圖表控制項讀出:
| Grok 4.7 推理檔 | CursorBench 4.0 分數 | 每任務平均成本 |
|---|---|---|
| Extra High | 46.3% | $6.01 |
| High | 43.9% | $4.69 |
| Medium | 41.6% | $3.49 |
| Low | 33.1% | $1.58 |
在這張廠商圖上,Extra High 的花費是 Low 的 3.8 倍,分數高 13.2 個百分點。控制項沒有印出樣本數、測試框架,也沒有說明這幾美元由哪些 token 構成。這是 xAI 報告的任務成本,不是 API 主控台的發票,也不能拿來和每百萬 token 的裸價直接對比。
所以「和 4.6 同價」仍然可能顯得貴。預設檔是 high。這張圖上 high 已經是 $4.69,Low 是 $1.58。代理式推理說明 適合討論迴圈該在哪裡停;定價上更窄的一點是:按你實際留下的推理檔,給每個完成的任務設預算。
「貴 2.5 倍」量的是什麼
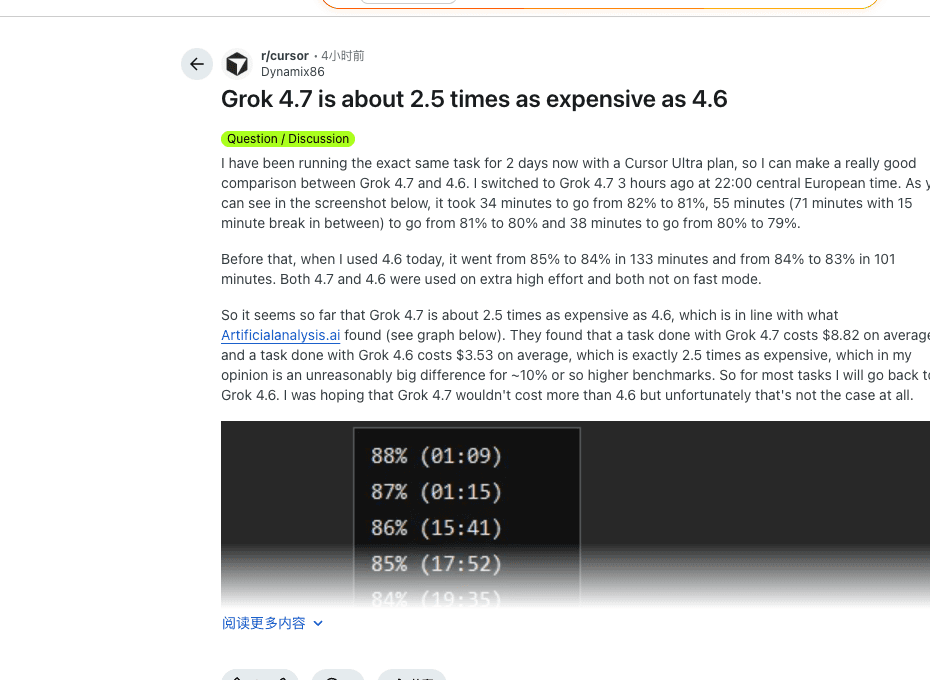
Dynamix86 在 Cursor Ultra 上把同一個任務跑了兩天,於歐洲中部時間 22:00 從 Grok 4.6 換到 Grok 4.7,並記錄每個用量百分點能撐多久。兩次都是 extra high,而且沒有開 fast mode。4.7 的三段大約是每個百分點 34、55、38 分鐘。當天更早的 4.6 是 133 與 101 分鐘。作者由此估成大約 2.5 倍。貼文還把一張 Artificial Analysis 圖讀成每任務 $8.82 對 $3.53。這兩個美元數只當作作者對截圖的讀法。本文沒有重測那張圖,Cursor 的額度百分比也不是 xAI API 的一列帳單。
兩則回覆仍在談成本:
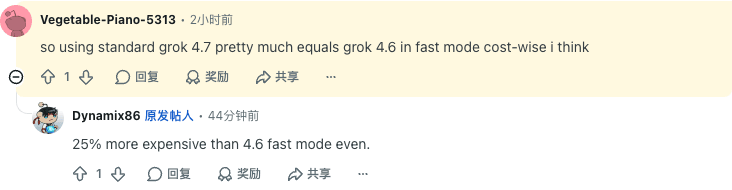
Vegetable-Piano-5313 寫道:“so using standard grok 4.7 pretty much equals grok 4.6 in fast mode cost-wise i think”。Dynamix86 回覆:“25% more expensive than 4.6 fast mode even.” 兩則都沒有貼出 token 日誌。它們提醒的是方案額度,不是第二張官方費率卡。
“Yep what an awful model release. Obviously benchmarks mean nothing anymore but the cost is clearly too high.” 這句是牌價帶來的衝擊。它沒有寫推理檔、fast mode 或 token 數。上面那張發布圖,才是不必把這則留言的結論當成事實也能核對的部分。
標題上的 $2 沒有寫出的列
20 萬門檻作用在整次請求。 19.9 萬 token 的提示詞仍走 $2 / $0.50 / $6。20 萬 token 的提示詞把每一個 token,包含輸出,都改到 $4 / $1 / $12。價格頁沒有「只計超出部分」這一列。
印出的長上下文 Fast 列,不是長上下文標準列的兩倍。 價格頁說 Grok 4.7 Fast 是同一模型跑在更快的基礎設施上,“at twice the standard token rates”,只在 Cursor 與 Grok Build,不在公開 API,也不在 Grok Build 免費額度裡。這句話下面的表是:
| 提示詞規模 | Fast 輸入 | Fast 快取輸入 | Fast 輸出 |
|---|---|---|---|
| 20 萬以下 | $4.00 | $1.00 | $12.00 |
| 20 萬及以上 | $6.00 | $1.50 | $18.00 |
20 萬以下,$4 / $1 / $12 正好是短上下文卡的 2 倍。20 萬以上,長上下文卡的 2 倍會是 $8 / $2 / $24。印出的一列是 $6 / $1.50 / $18,也就是長上下文標準費率的 1.5 倍、短上下文標準費率的 3 倍。按印出的列做預算。不要把長上下文標準列乘二,再把它叫做 Fast。
Cursor 用 25.6 萬,而且 Pro 及以上預設就是 Fast。 Cursor 的 Grok 4.7 文件 於 2026 年 9 月 22 日打開,標準隨選用量是每百萬輸入 $2、快取輸入 $0.50、輸出 $6。Fast 是 $4 / $1 / $12。輸入超過 25.6 萬 token 後,標準請求按這些標準費率的 2 倍計,Fast 請求按 3 倍計,上限 50 萬。表中各列是 Grok 4.7 $2 / — / $0.50 / $6,Fast $4 / — / $1 / $12,50 萬 $4 / — / $1 / $12,50 萬 Fast $6 / — / $1.50 / $18。快取寫入欄是橫線。Cursor 還寫明,Pro 及以上的預設速度檔是 Fast;Start 方案(僅印度)把 Grok 4.7 鎖在 medium 推理和標準速度。一個 22 萬 token 的提示詞,在 xAI API 上已經是長上下文,在 Cursor 裡仍可能走標準檔。
Batch 不是這張卡的折扣槓桿。 價格頁把 20% 批次折扣只給 grok-4.3 和 grok-4.20 系列,並寫明未列出的模型沒有批次折扣。grok-4.7 自己的頁面寫 Batch API 不支援。放進隔夜佇列,不會把這個模型打對折。
工具是第二個計量表。 使用 xAI 伺服器端工具的請求,token 和呼叫次數都要付。網頁搜尋(web_search)和程式碼執行是每 1,000 次 $5。集合搜尋是每 1,000 次 $2.50。檔案附件(attachment_search)是每 1,000 次 $10。自 2026 年 9 月 21 日太平洋時間中午 12 點起,X Search 改為每 1,000 則貼文 $5、每 1,000 個使用者資料 $10,不再是每 1,000 次呼叫 $5。view_image、view_x_video 和遠端 MCP 沒有呼叫費,只計 token。影像搜尋算在網頁搜尋裡。
美國端點是 1.1 倍。 發往 https://us.api.x.ai/v1 的請求按全球 token 費率的 1.1 倍計。價格頁為 grok-4.7 印出的是 20 萬以下 $2.20 / $0.55 / $6.60,以上 $4.40 / $1.10 / $13.20。先套用快取折扣,再乘係數。該頁寫明這個端點目前涵蓋 grok-4.7 和 grok-4.6。
優先處理是另外的 2 倍,而且只有回應寫明時才算。 Priority 對輸入、輸出、快取和推理 token 按標準費率的 2 倍計,快取折扣在乘數之前。只有回應確認 "service_tier": "priority" 時才按優先價付。它不用於 Batch。Fast 是另一項產品,不是這個 API 開關。
家族階梯裡,真正比較便宜的那一列
反直覺的一列不是 Grok 4.7 的新折扣。Grok 4.5 的快取輸入是 $0.30,4.6 和 4.7 是 $0.50,20 萬以下的輸入和輸出仍是 $2 和 $6。如果迴圈很吃快取,而且 4.5 已經夠用,新卡是快取讀取變貴,不是降價。grok-build-0.1 的每個短上下文數字大約是 4.7 的一半($1 / $0.20 / $2),上下文視窗是 25.6 萬,不是 50 萬。它是另一個模型 id,不是 4.7 的一個推理檔。
另一件反直覺的事是推理檔。Extra High 沒有單獨的輸入價。它花的是更多按 $6 計費的輸出 token。Cursor 文件寫,xhigh、high、medium、low 之間的差距比 Grok 4.6 更寬,更難的任務會想得更久。把預設留在 high,本身就是一次採購決定。
模型拒絕時,你仍然在付錢
這張卡上,拒絕不是免費的一列。
如果系統在 Responses API 生成之前 抓住使用準則違規,xAI 收 每請求 $0.05。
如果請求被判定違規,但生成已經跑完,這次生成仍然計費。
快取輸入是折扣(20 萬以下是 $0.50 而不是 $2.00)。文字費率卡沒有單獨的快取寫入價。Cursor 的寫入欄是橫線。未命中快取的輸入按完整輸入價計。
產生了 token 的重試和失敗嘗試仍然是用量。費率卡沒有把它們免掉。
Grok 聊天訂閱、Cursor 方案額度和 API 發票是三件不同的東西。本文不把消費者方案的月費換算成 API 美元;2026 年 9 月 22 日沒有把那個月費當作即時結帳數字重新核對。
一則 Hacker News 留言引用某頁,稱 Grok 4.7(xhigh)是 “$0.00 per 1M input tokens” 與 “$0.00 per 1M output tokens”,然後說網域 “appropriately descriptive”。第三方小工具上的零,不是降價。上面的 API 卡才是用來做預算的。
模型實際跑在哪裡
Grok 4.7 文件 列出公開 API(grok-4.7)、美國區域端點、作為預設程式代理模型的 Grok Build、所有方案上的 Cursor,以及 OpenRouter、Vercel、Cloudflare 這些閘道。本文沒有重審閘道牌價;和 $2 / $6 對不上的搜尋摘要,不是抛開官方卡的理由。
Cursor 個人和團隊方案的用量池包含 Grok 4.7、Grok 4.6、Grok 4.5 和 Composer 2.5。這個池是額度,不是預先買好的一疊 API token。Pro 及以上預設 Fast,表示方案可以在每一輪都沒有單獨打開的情況下,按 Fast 那一列消耗。
Grok Build 的免費層不含 Fast。發布頁還說可以在 x.ai/build 試用 Grok Build。那個頁面上的 “try for free” 並不是說 grok-4.7 的 API token 免費。
兩筆 API 預算
下面只用 xAI 的卡:沒有工具、沒有美國 10%、沒有 priority 開關、沒有重試。這是算術,不是預測。
門檻以下、預設卡上的一次短回答。 1 萬未快取輸入 token,2,000 輸出 token:
(10,000 × $2 + 2,000 × $6) / 1,000,000 = $0.032同一形狀走印出的短上下文 Fast,是 $0.064。輸出價是輸入價的 3 倍,所以提示詞很小的時候,想得久仍然占大頭。
跨過 20 萬的一次冷啟動代理提示詞。 25 萬未快取輸入 token,8,000 輸出 token。長上下文費率作用於全部 token:
(250,000 × $4 + 8,000 × $12) / 1,000,000 = $1.096同樣的 token 數如果仍按短上下文計價,會是 $0.548。差額就是這條門檻。快取命中 90%、仍走長上下文時:
(25,000 × $4 + 225,000 × $1 + 8,000 × $12) / 1,000,000 = $0.421印出的 20 萬以上 Fast、冷輸入,是 (250,000 × $6 + 8,000 × $18) / 1,000,000 = $1.644。若把長上下文標準列直接加倍,會算出並不存在的 $2.192。用 $1.644。
本機計算
估算每月 API 帳單
費率核對於 2026 年 9 月 22 日的 xAI 官方頁面。輸出只計一次,並按輸出價涵蓋思考 token。你輸入的數字不會離開這個頁面。
輸入達到或超過 20 萬 token 時,整次請求改用該模型的長上下文費率。Fast 使用價目表上的 Fast 列,不是長上下文費率的單純兩倍。不含工具呼叫、美國端點 10% 加價、優先處理、重試,以及 Cursor 單獨的 25.6 萬門檻。 核對費率表
計算器留在瀏覽器裡。輸入達到 20 萬 token 時,它把整次請求切到長上下文費率;Fast 選項只對 grok-4.7 使用印出的 Fast 表。grok-4.6 和 grok-4.5 留在各自的標準列上,這樣 4.5 的快取差價仍然看得見。它不算工具費、美國 10%、priority、重試,也不算 Cursor 的 25.6 萬門檻。鎖定預算前,重新打開 官方價格頁。
費率卡之後,有一個地方可以跑這個模型
知道費率卡,並不會把模型接到你已經打開的頁面和檔案上。Tabbit 瀏覽器 做的是這一步:模型選擇器、目前頁面和本機檔案在同一個介面裡,比較一條路線是一次選擇,而不是再接一套計費。
界線就是這一節的重點。Tabbit 不取代 xAI 的發票,也不改變 Cursor 的 25.6 萬規則。Grok 4.7 模型頁 (简体中文) 列出了這個模型,並說明它在 Tabbit 裡是否出現,取決於帳號當時的選擇器。提示詞筆記 (简体中文) 和 評測筆記 (简体中文) 記錄的是 API 怎麼呼叫、公開基準怎麼讀。它們不是一份量過的 Tabbit 帳單。本文沒有在 Tabbit 裡跑過計時任務,所以不聲稱 Tabbit 的費用、延遲或成功率。
 Tabbit Browser
如果工作本身就是瀏覽器工作階段,從 AI 瀏覽器指南、代理式瀏覽器概覽、什麼是代理式瀏覽器 和 瀏覽器自動化指南 開始。2026 瀏覽器比較 和 Tabbit 使用筆記 把用戶端選擇和 token 費率分開講。
你實際在選的是哪一種帳單
| 工作負載 | 帳單主要由什麼決定 | 從這裡開始 | 要注意 |
|---|---|---|---|
| 短 API 呼叫 | 每百萬 $6 的輸出 token | grok-4.7,low 或 medium | 預設檔是 high |
| 20 萬以下的重複提示詞 | $0.50 的快取讀取 | 穩定快取鍵的標準 API | 若品質允許,4.5 的快取讀取是 $0.30 |
| API 上達到或超過 20 萬的提示詞 | 整次請求的門檻 | 先改結構,或按 $4 / $12 做預算 | 不是「只計超出部分」 |
| 同一條提示詞放在 Cursor 裡 | Cursor 的 25.6 萬線和 Fast 預設 | 除非延遲需要,否則用標準速度 | Pro 及以上預設 Fast |
| 延遲優先於成本 | 印出的 Fast 卡 | Cursor 或 Grok Build 的 Fast | 不在公開 API;沒有 Grok Build 免費額度 |
| 工具很多的代理 | 每千次 $5 再加 token | 限制搜尋和程式碼執行 | X Search 的計費在 2026-09-21 改過 |
結論
當任務長到額外的推理檔配得上它花掉的 token 時,再買 Grok 4.7,並且有意識地買 推理檔和執行表面。API 卡仍是 Grok 4.6 那張卡。這張圖上 Low 是每任務 $1.58,Extra High 是 $6.01。除非你已經為整次請求按 $4 / $12 算過價,否則在 API 上把提示詞留在 20 萬 token 以下。Fast 按印出的 $4 / $1 / $12 和 $6 / $1.50 / $18 表來看,並記住 Cursor 在 25.6 萬翻轉,不是 20 萬。更便宜的快取或半價那一列已經夠用時,用 grok-4.5 或 grok-build-0.1。不要等一個模型頁已經寫明不存在的 Batch 折扣。
這個模型的總覽、評測和替代品文章還沒有發布。在那之前,Grok 4.6 文章、模型筆記 (简体中文) 和下面的官方頁面是可核對的路徑。按月承諾之前再看一次費率卡;同一張價格頁上的 X Search 變更日期就是 2026 年 9 月 21 日。
來源
xAI API 價格:文字費率、Fast 表、工具、Batch 名單、美國端點、priority、違規費;2026-09-22 核對
grok-4.7 模型頁:$2 / $0.50 / $6、長上下文開關、Batch 不支援、預設推理檔 high
Grok 4.7 文件:模型 id、Fast 在哪裡、美國 10%、執行位置;最後更新 2026-09-21
Introducing Grok 4.7:起步價、快速變體那一句、CursorBench 成本點
Cursor Grok 4.7 文件:25.6 萬門檻、Fast 預設、費率列;2026-09-22 打開
社群紀錄及圖說中的條件:r/cursor 1wmswj9、HN 49789558

常見問題
Grok 4.7 要多少錢?
2026 年 9 月 22 日核對的 xAI API 上,提示詞不足 20 萬 token 時,grok-4.7 為每百萬輸入 token $2、快取輸入 $0.50、輸出 $6。達到或超過該門檻後,整次請求改為 $4、$1 與 $12。公開 API 的模型 id 是 grok-4.7。
Grok 4.7 和 Grok 4.6 是同一個價錢嗎?
短上下文與長上下文兩列都與 Grok 4.6 相同:20 萬輸入 token 以下是 $2/$0.50/$6,達到或超過則為 $4/$1/$12。這是牌價。xAI 自己的 CursorBench 仍把 Grok 4.7 Extra High 標成每任務 $6.01、Low 標成 $1.58,推理檔會改帳單,但不改費率卡。一位 Cursor Ultra 使用者在 extra high、關閉 fast mode 的條件下,把同一任務的額度消耗估成大約是 Grok 4.6 的 2.5 倍。
Grok 4.7 的長上下文怎麼計價?
在 xAI API 上,提示詞一旦達到 20 萬 token,該請求裡的每個 token 都按每百萬 $4 輸入、$1 快取輸入、$12 輸出計費。Cursor 的門檻不同:標準隨選用量要到 25.6 萬輸入 token 之後才加倍,上下文最多 50 萬。不要把兩條線混成一條。
Grok 4.7 Fast 要多少錢?
xAI 價格頁列出的 Fast 只在 Cursor 與 Grok Build 提供:提示詞 20 萬 token 以下是每百萬 $4/$1/$12,達到或超過則為 $6/$1.50/$18。正文另寫著標準 token 費率的兩倍。印出的長上下文 Fast 列是長上下文標準列的 1.5 倍,不是兩倍。Fast 不在公開 xAI API 上,也不計入 Grok Build 的免費額度。
Batch API 會給 Grok 4.7 打折嗎?
不會。grok-4.7 模型頁把 Batch API 標為不支援。價格頁的 20% 批次折扣只給 grok-4.3 與 grok-4.20 系列等更早的模型,並寫明不在名單上的模型沒有批次折扣。
工具呼叫和拒絕回答要另外付錢嗎?
伺服器端工具在 token 之外另計。網頁搜尋與程式碼執行為每 1,000 次呼叫 $5。自 2026 年 9 月 21 日太平洋時間中午 12 點起,X Search 改為每 1,000 則擷取的貼文 $5、每 1,000 個使用者資料 $10。生成前就被判定違反使用準則的 Responses API 請求收 $0.05。已經生成完成再被判定違規的,token 仍然計費。