對話模式順的時候
實測者描述回覆更生動、對話更即興,角色活在當下,而不是在敘述自己的選擇。
DeepSeek V3.2 · 角色扮演實測指南
DeepSeek V3.2 已經成為許多 SillyTavern 用戶的日常對話模型,但角色扮演的表現因模式而異。社群實測者回饋:對話(非思考)模式在角色中往往更自然、更有樂趣,而思考模式擅長規劃,卻可能顯得過分刻意。在投入長聊之前,先跑一個短測試。
社群回饋是體驗,不是跑分。本頁不提供越獄或繞過安全控制的方法。
用戶真實回饋
被引用最多的實測用五張角色卡、240 則訊息比較了兩種模式。帖文裡呈現的規律是:自然感和樂趣通常是非思考模式勝出;思考模式則容易出現刻意感。
實測者描述回覆更生動、對話更即興,角色活在當下,而不是在敘述自己的選擇。
面對密集的情節編排或長線規劃,部分用戶更偏愛思考模式。它能把後果梳理清楚,但有時會用分析蓋過場景本身。
一則高讚留言把推理模型形容成「聰明但神經質的演員」:恰好在最需要即興的地方過於刻意。
有用戶覺得非思考的 DeepSeek 承載設定和 lore 更自然。他們自己強調這只是體感、需要再測,而不是測量結論。
15 分鐘評測
照搬社群方法:同一張卡、同一段開場、只變一個變數。給回覆為場景做了什麼打分,而不是看某一段寫得多漂亮。
寫下五個事實:角色目標、語氣、目前地點、剛發生的變化、一條禁止假設。要求輸出 250 到 450 字,並推動一個改變場景的動作。
用完全相同的開場,先跑非思考模式,再開思考模式各試一次。在改動其他任何設定之前,每個分支先續聊兩輪。
即興感、情節推進、指令保持、重複控制各給 0、1 或 2 分。記錄思考模式在哪加了規劃、又抽走了存在感。
每次只改一條提示詞規則或設定。如果四個分數沒有變化,就回退它,而不是繼續疊指令。
SillyTavern 路徑
SillyTavern 提供角色卡、lorebook、預設和群聊。endpoint 和前端各自有各自的坑。
預設名字是社群約定。檔案找作者要,並留意授權。預設不是萬能解。
DeepSeek 會原地升級 API 模型名,請以官方 API 文件目前列出的對話模型識別碼為準,不要自行拼湊版本字串。
把角色事實和場景狀態寫進角色卡或系統提示。任何思考模式的指令,都要先和乾淨的對照分支比較再採信。
開一條思考關閉的分支和一條開啟的分支。記錄延遲、長度和場景推進。不要把隱藏推理當作品質保證。
加一條簡短的輸出規則,例如「用一個具體變化推進場景;不要重複最近兩輪出現過的感官細節」,然後驗證模型是否遵守。
瀏覽器路徑
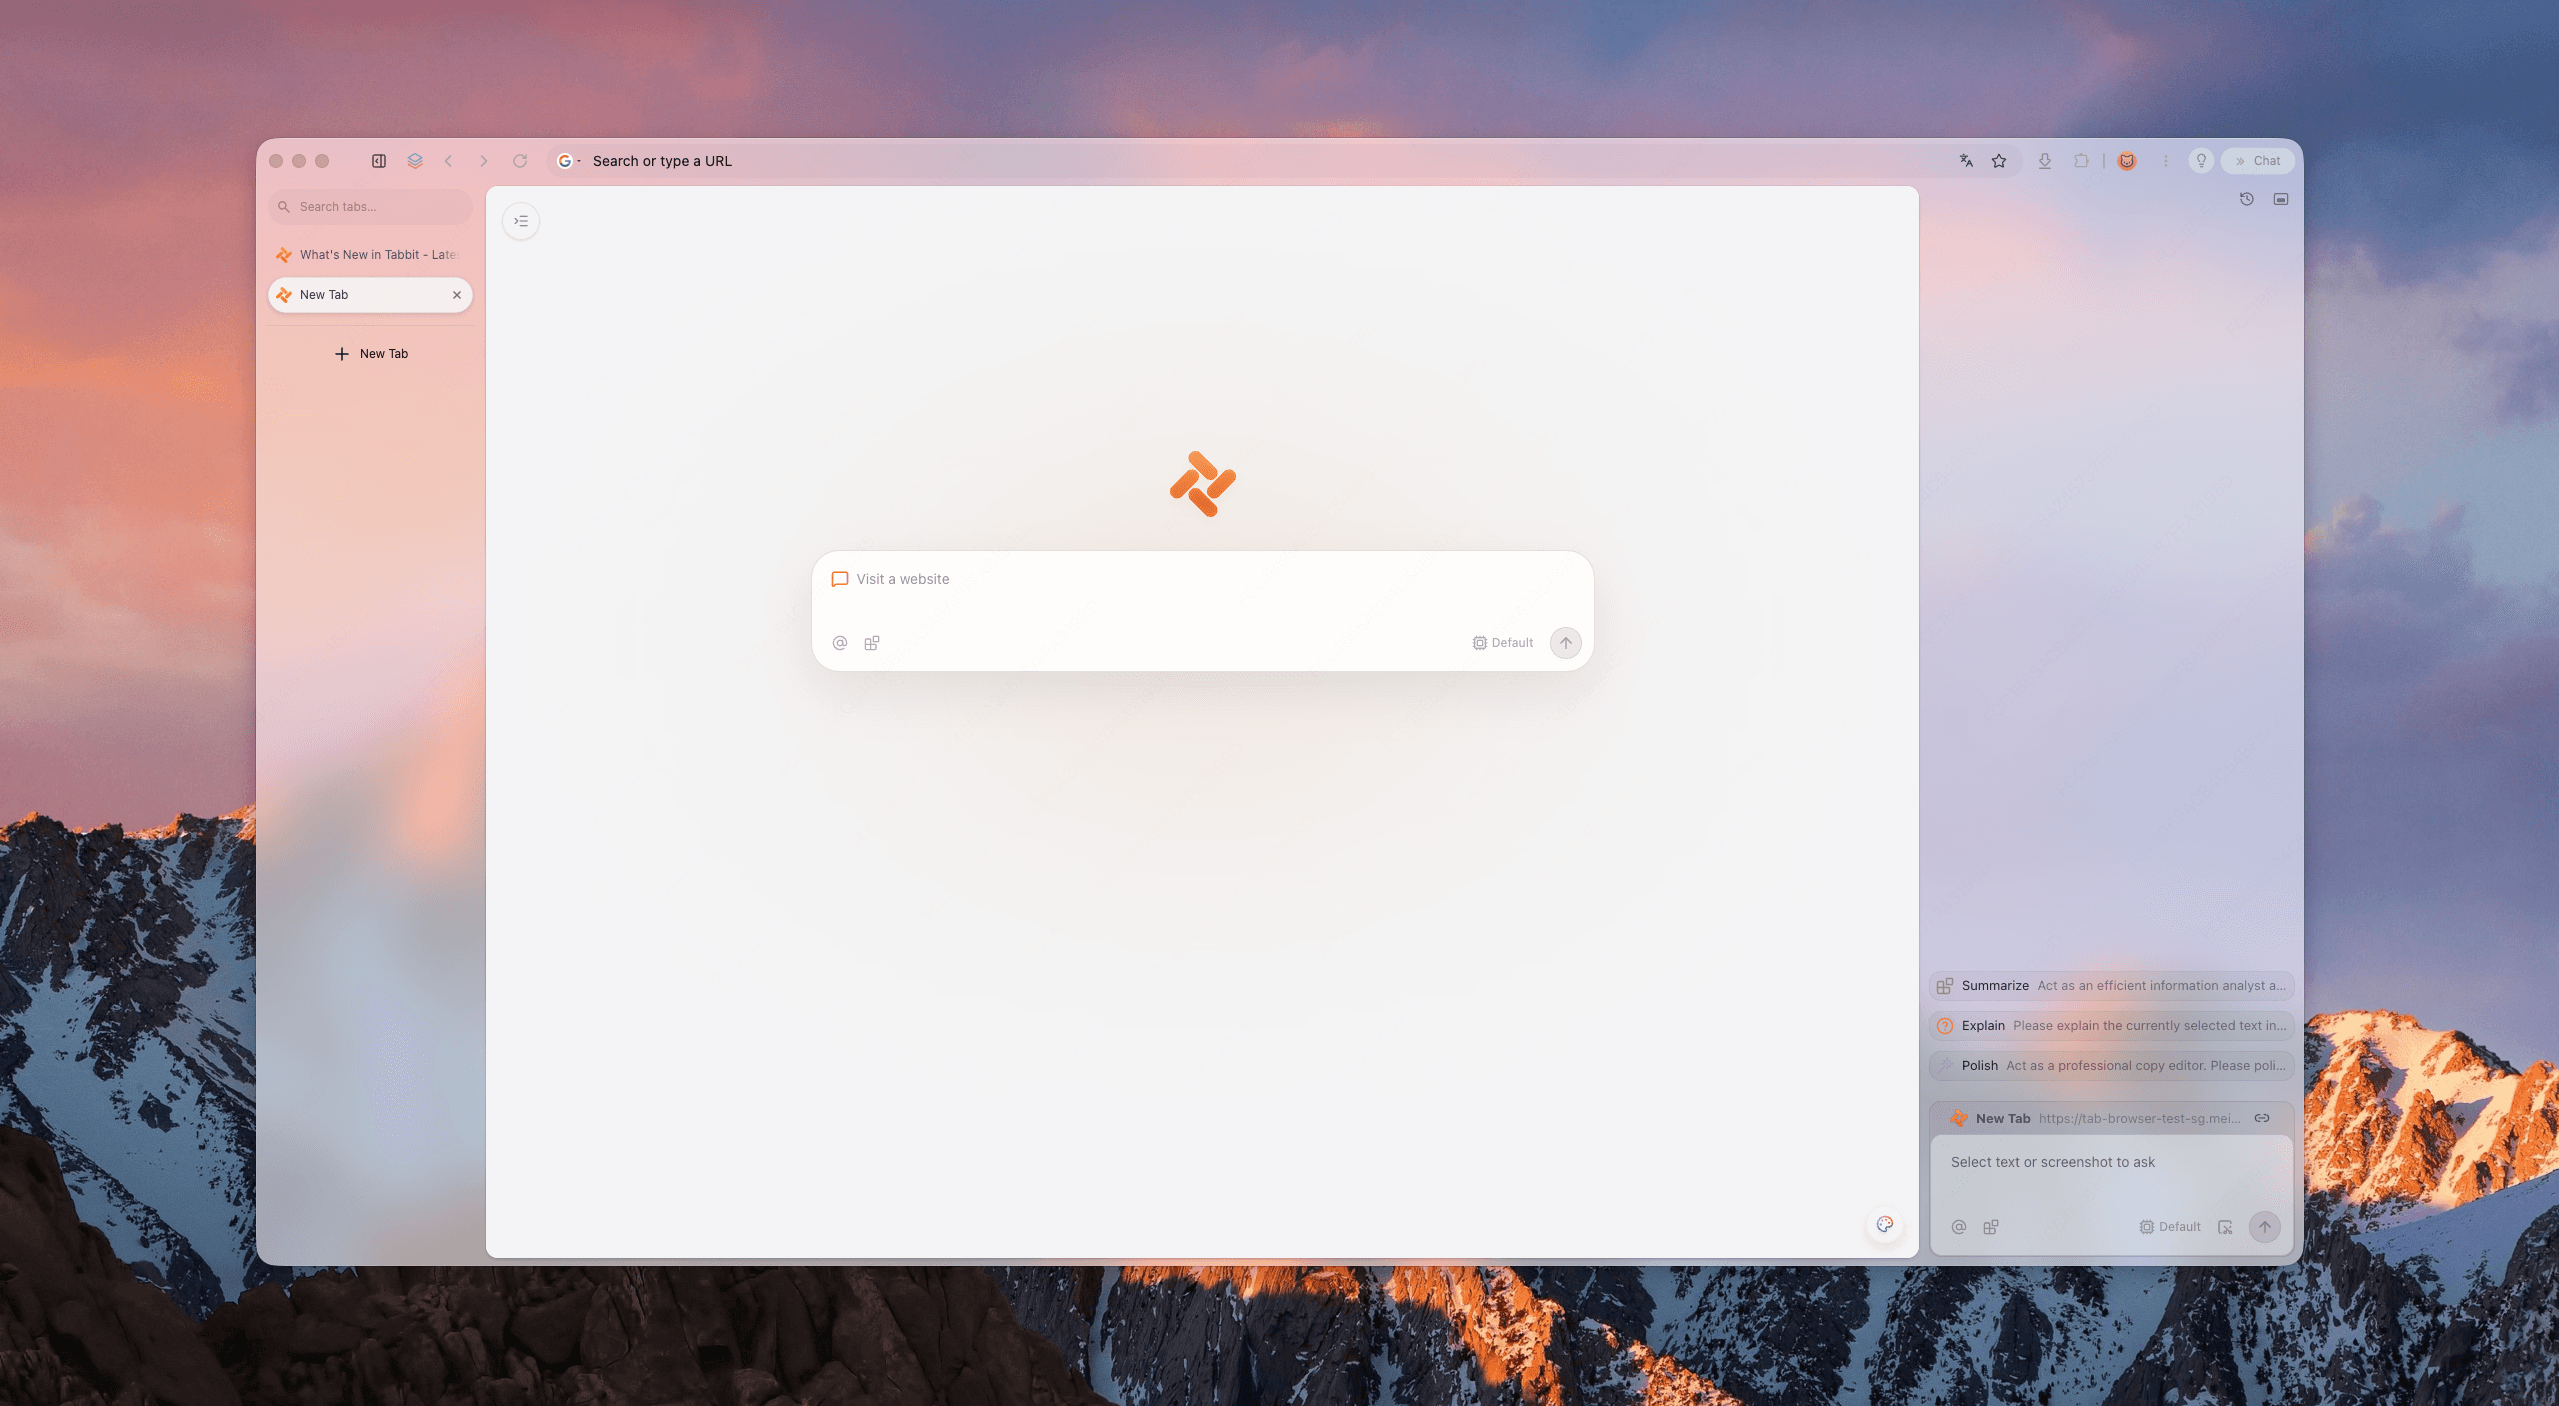
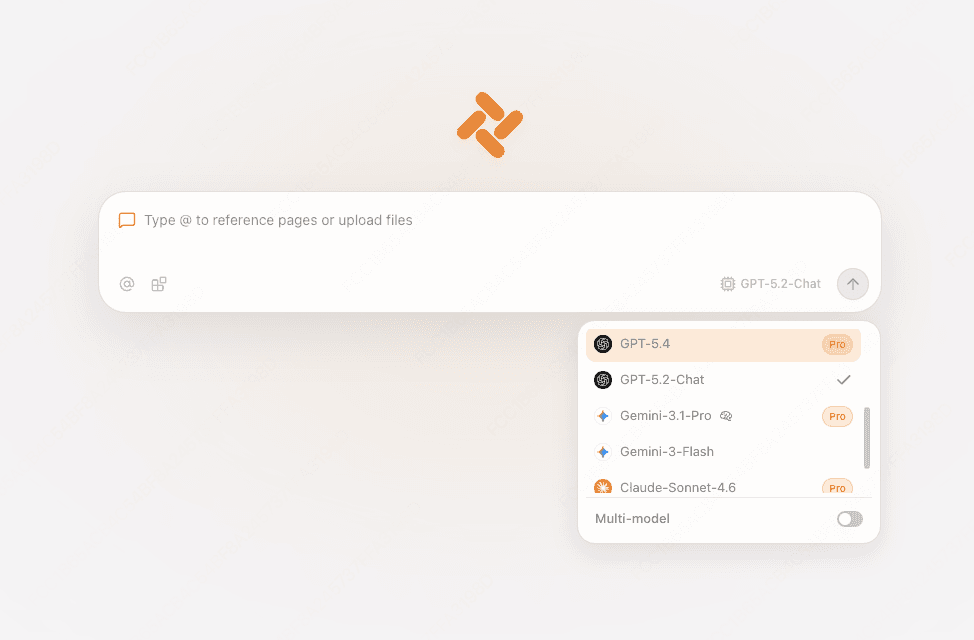
Tabbit 把瀏覽器和對話放在一起。在版本支援的條件下,在產品內的模型選擇器裡選 DeepSeek V3.2,再把角色 wiki、設定表或寫作參考帶進對話。
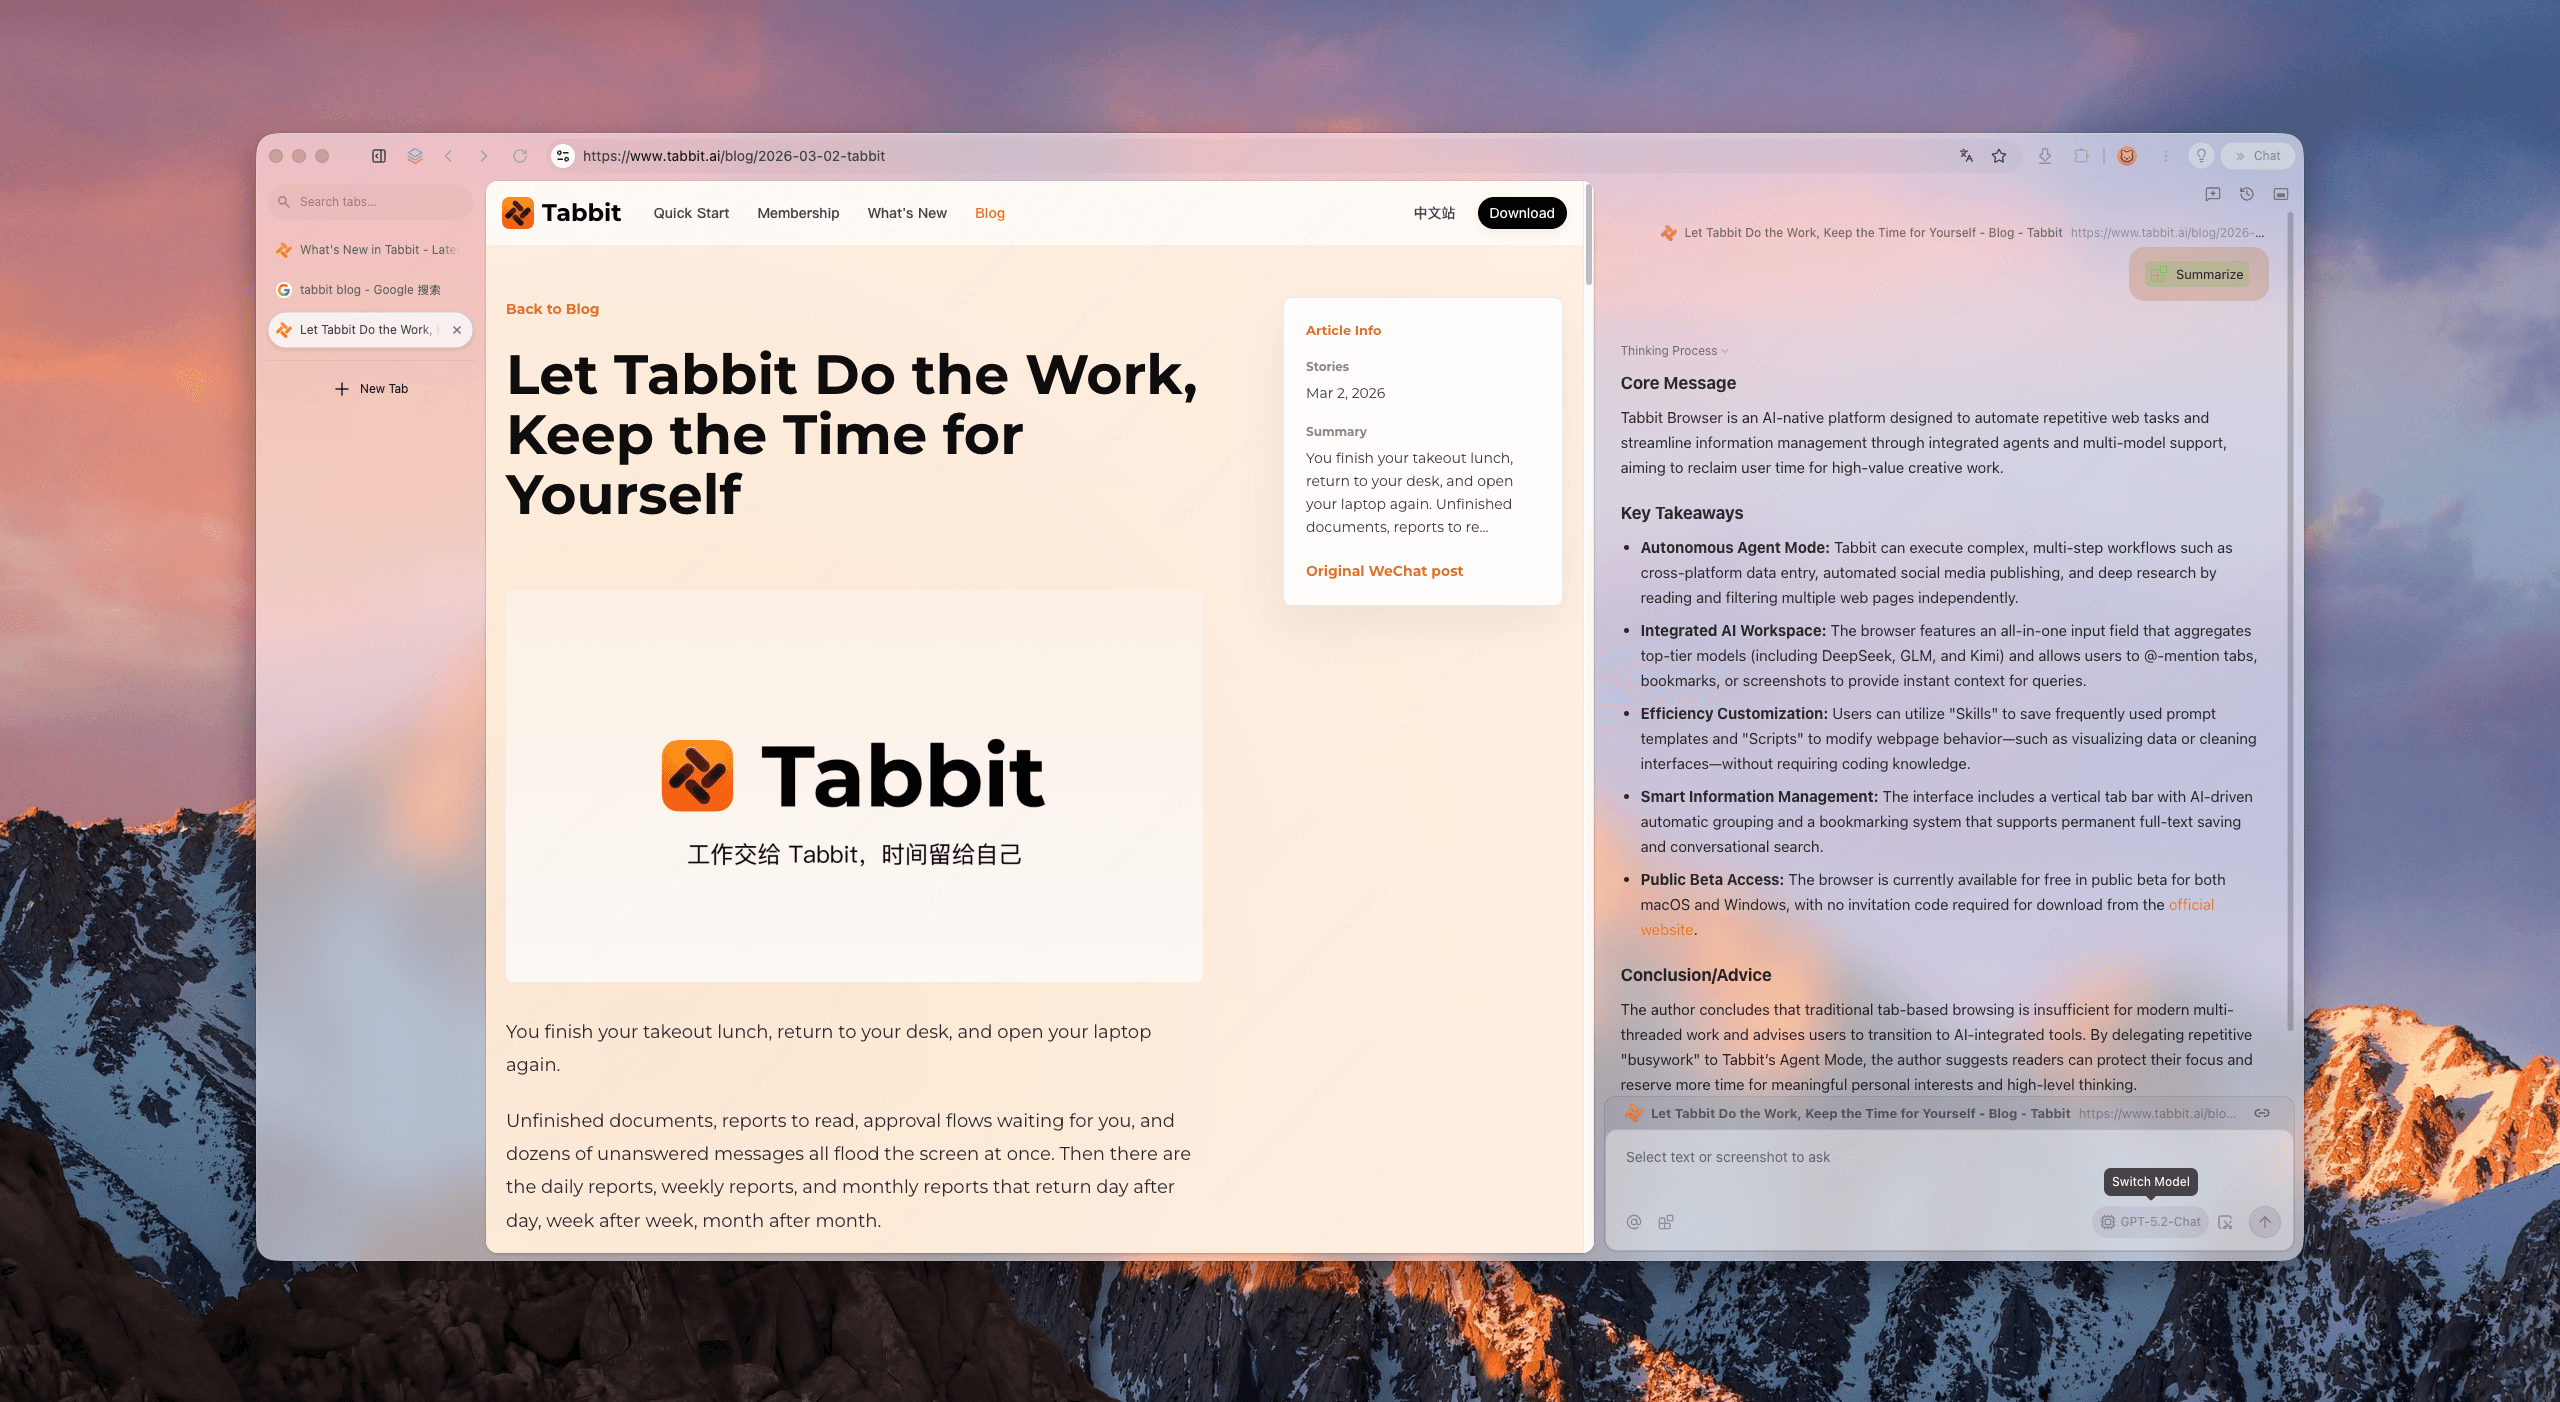
把角色卡、lore 頁面或你自己的場景大綱留在分頁裡。直接對著頁面工作,不用把段落逐段複製進聊天框。
打開 Tabbit 的模型選擇器,如果列表中有 DeepSeek V3.2 就選它。可用性隨版本、地區、帳號和灰度而變化。
輸入 @ 引用打開的分頁、截圖或檔案。可以要求續寫一段場景、做一次一致性檢查,或在不違背頁面事實的前提下改寫。
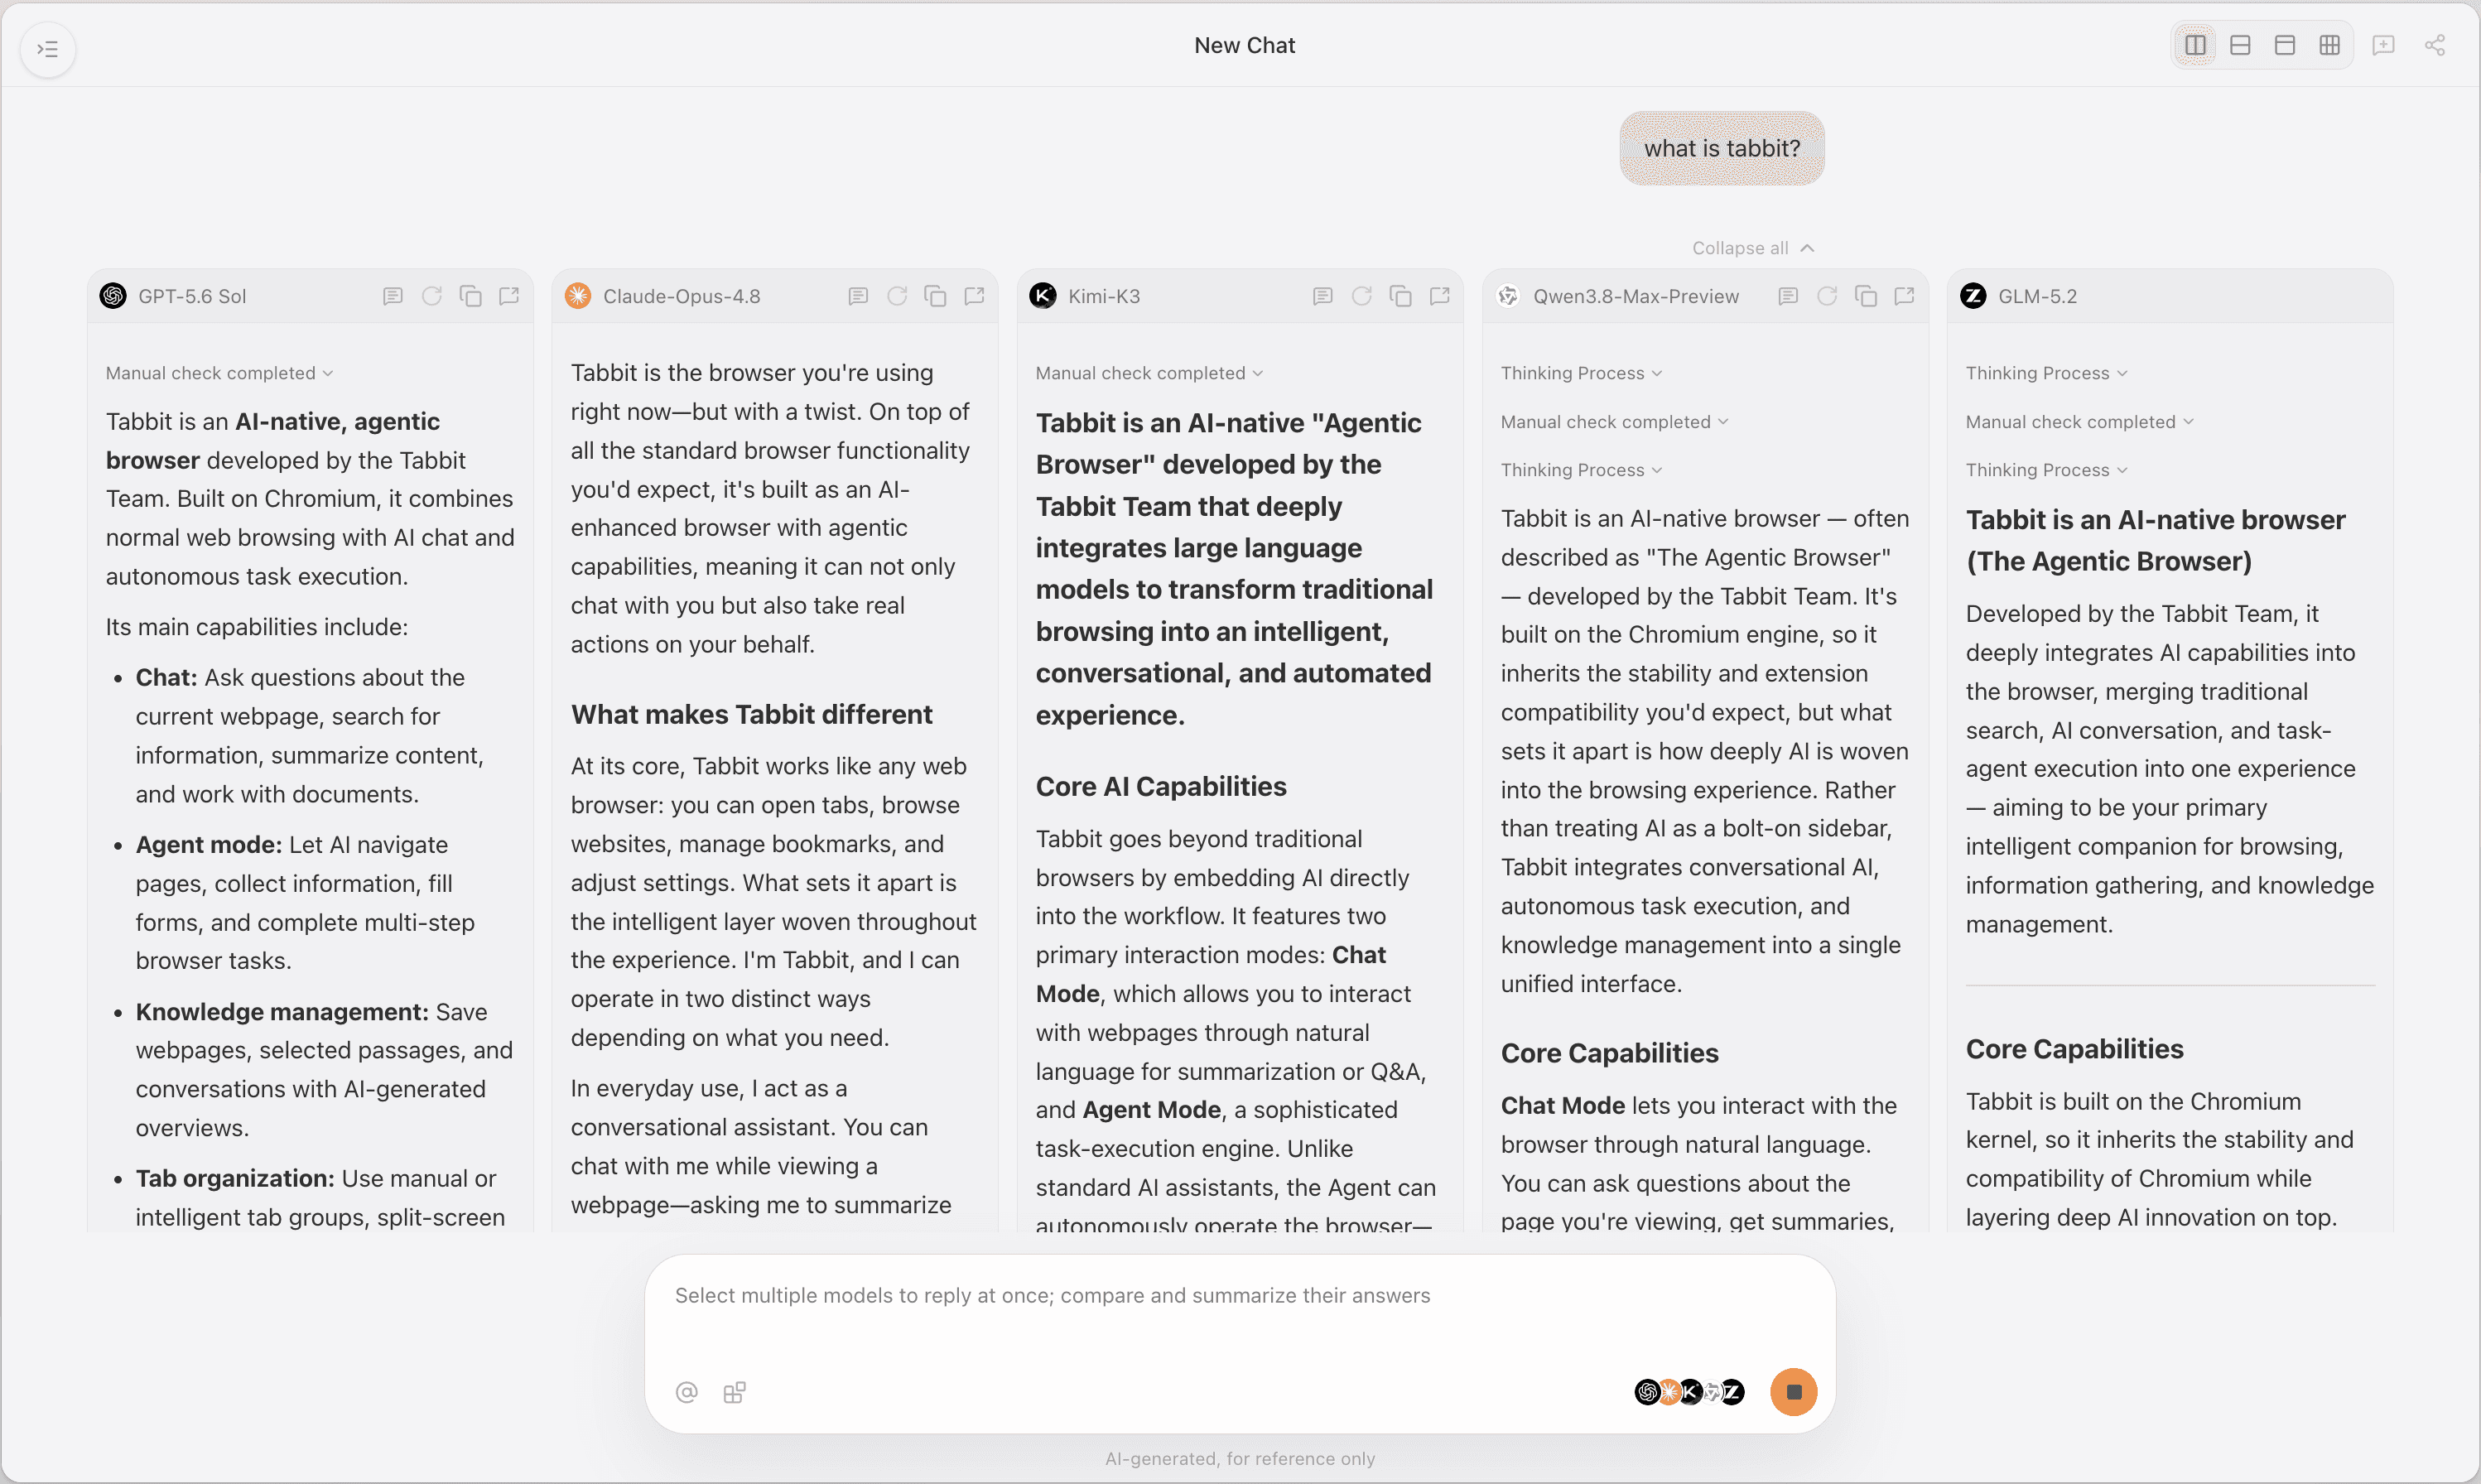
用多模型對話把同一段提示交給另一個模型,為語氣或場景推進取得第二意見。
選對前端
兩者解決的是工作流的不同部分。SillyTavern 是專門的 RP 駕駛艙;當角色素材本來就散落在網頁和檔案裡時,Tabbit 更順手。
| 需求 | SillyTavern | Tabbit |
|---|---|---|
| 角色卡和 lorebook | 原生支援 | 引用頁面或檔案 |
| 預設和提示詞控制 | 深度控制 | 系統提示和 Skills |
| RP 旁邊查網頁 | 靠擴充功能或複製貼上 | 打開的分頁用 @ 變成上下文 |
| 思考與對話分支對比 | 預設和 API 設定 | 瀏覽器內多模型對話 |
| 首次上手 | 前端、endpoint、key、預設 | 安裝後看模型選擇器 |
Tabbit
對比分支
01
把角色卡、lore 頁面或你自己的場景大綱留在分頁裡。直接對著頁面工作,不用把段落逐段複製進聊天框。
02
瀏覽器內多模型對話
03
輸入 @ 引用打開的分頁、截圖或檔案。可以要求續寫一段場景、做一次一致性檢查,或在不違背頁面事實的前提下改寫。
保持誠實
帖文混合了版本、預設、思考設定、角色卡和個人口味。把它們當作你自己受控測試的假設。
推理和 agent 分數衡量不了你的卡裡的角色語氣、節奏、幽默或一致性。跑分結論和 RP 體感要分開看。
角色扮演指南可以討論邊界和提示詞行為,但不幫助規避安全系統。請寫清楚、合法的場景邊界。
Tabbit 的模型選擇器是可用性的唯一事實來源。本頁不承諾每個版本和帳號都能看到 DeepSeek V3.2。
看原始證據
上面的觀察來自公開的社群討論和官方文件。打開來源可以看到完整語境。
常見問題
社群回饋混合但可用:對話(非思考)模式常被形容為在角色中更即興、更有樂趣;思考模式規劃更好但容易顯得刻意。先在自家卡上跑三遍測試再下結論。
大多數日常和成熟主題的場次,實測者偏向非思考。長線劇情或複雜世界狀態時,開思考模式,用同一段開場對比兩個分支。
取決於角色卡、預設和模式。有用戶覺得 V4 更快、更會推進場景,但 V3.2 在 RP 前端上依然流行。用同一場景親測兩個模型,比信任何單一排名可靠。
使用 OpenAI 相容的 Chat Completions endpoint,在 DeepSeek API 文件確認目前模型名,角色事實寫進角色卡或系統提示,並把思考模式開和關當作兩個獨立分支測試。
DeepSeek V3.2 已列入 Tabbit 支援的模型目錄。打開產品內的模型選擇器,確認你的版本和帳號是否可用。
角色頁面保持打開,選好模型,一口氣跑完思考與非思考的分支對比。
macOS 和 Windows 免費下載。