悬疑场景
维持角色语气
回复是否遵循人设语气,而不是反复复述人物介绍?
SillyTavern 模型选择
没有一个模型适合所有角色卡。可以先参考近期使用情况,再用自己能接入的服务,对同一张角色卡和场景进行比较。
查看当前候选使用热度只说明某个平台网络上的采用情况,不是受控的角色扮演质量测试,也不保证能接入 SillyTavern。
带日期的采用情况
查看日期:2026 年 9 月 23 日
该榜单说明,它根据过去 7 天经 OpenRouter 处理的输入与输出 token 排序。指标反映该网络的使用量,不是 SillyTavern 专属流量或文笔质量。
| 排名 | 模型 | 榜单使用占比 |
|---|---|---|
| 01 | GLM 5.3 Flash | 16.7%本次快照中占比最高;仅代表采用情况。 |
| 02 | DeepSeek V4.1 Flash | 8.0%查看时在该榜单中按使用量排名第二。 |
| 03 | Tencent Hy4 preview | 6.5%排名第三;预览版可能影响可用性。 |
| 04 | GPT-5.6 Luna | 6.2%排名第四;实际接入和权限因服务而异。 |
| 05 | DeepSeek V4 Flash 0731 | 6.0%排名第五;请核对后端中的准确模型 ID。 |
这份有日期的快照会变化。modelgrep 的 SillyTavern 页面使用另一种 OpenRouter 角色扮演占比筛选,排序不同;两者都不是 SillyTavern 专项测试。
按角色卡选择
为每个模型使用相同的角色卡、开场白、上下文上限、生成设置和输出长度。记录可观察的表现,不要把一句精彩回复当作充分证据。
悬疑场景
回复是否遵循人设语气,而不是反复复述人物介绍?
维修场景
故事是否出现变化或可执行的选择,还是反复围绕同一细节打转?
对话场景
进入下一轮后,模型是否记得刚才的选择和后果?
这些是评估提示,不是实测榜单结果。请跨多个回合重复测试,并分别记录延迟、价格和服务商限制。
可选的比较流程
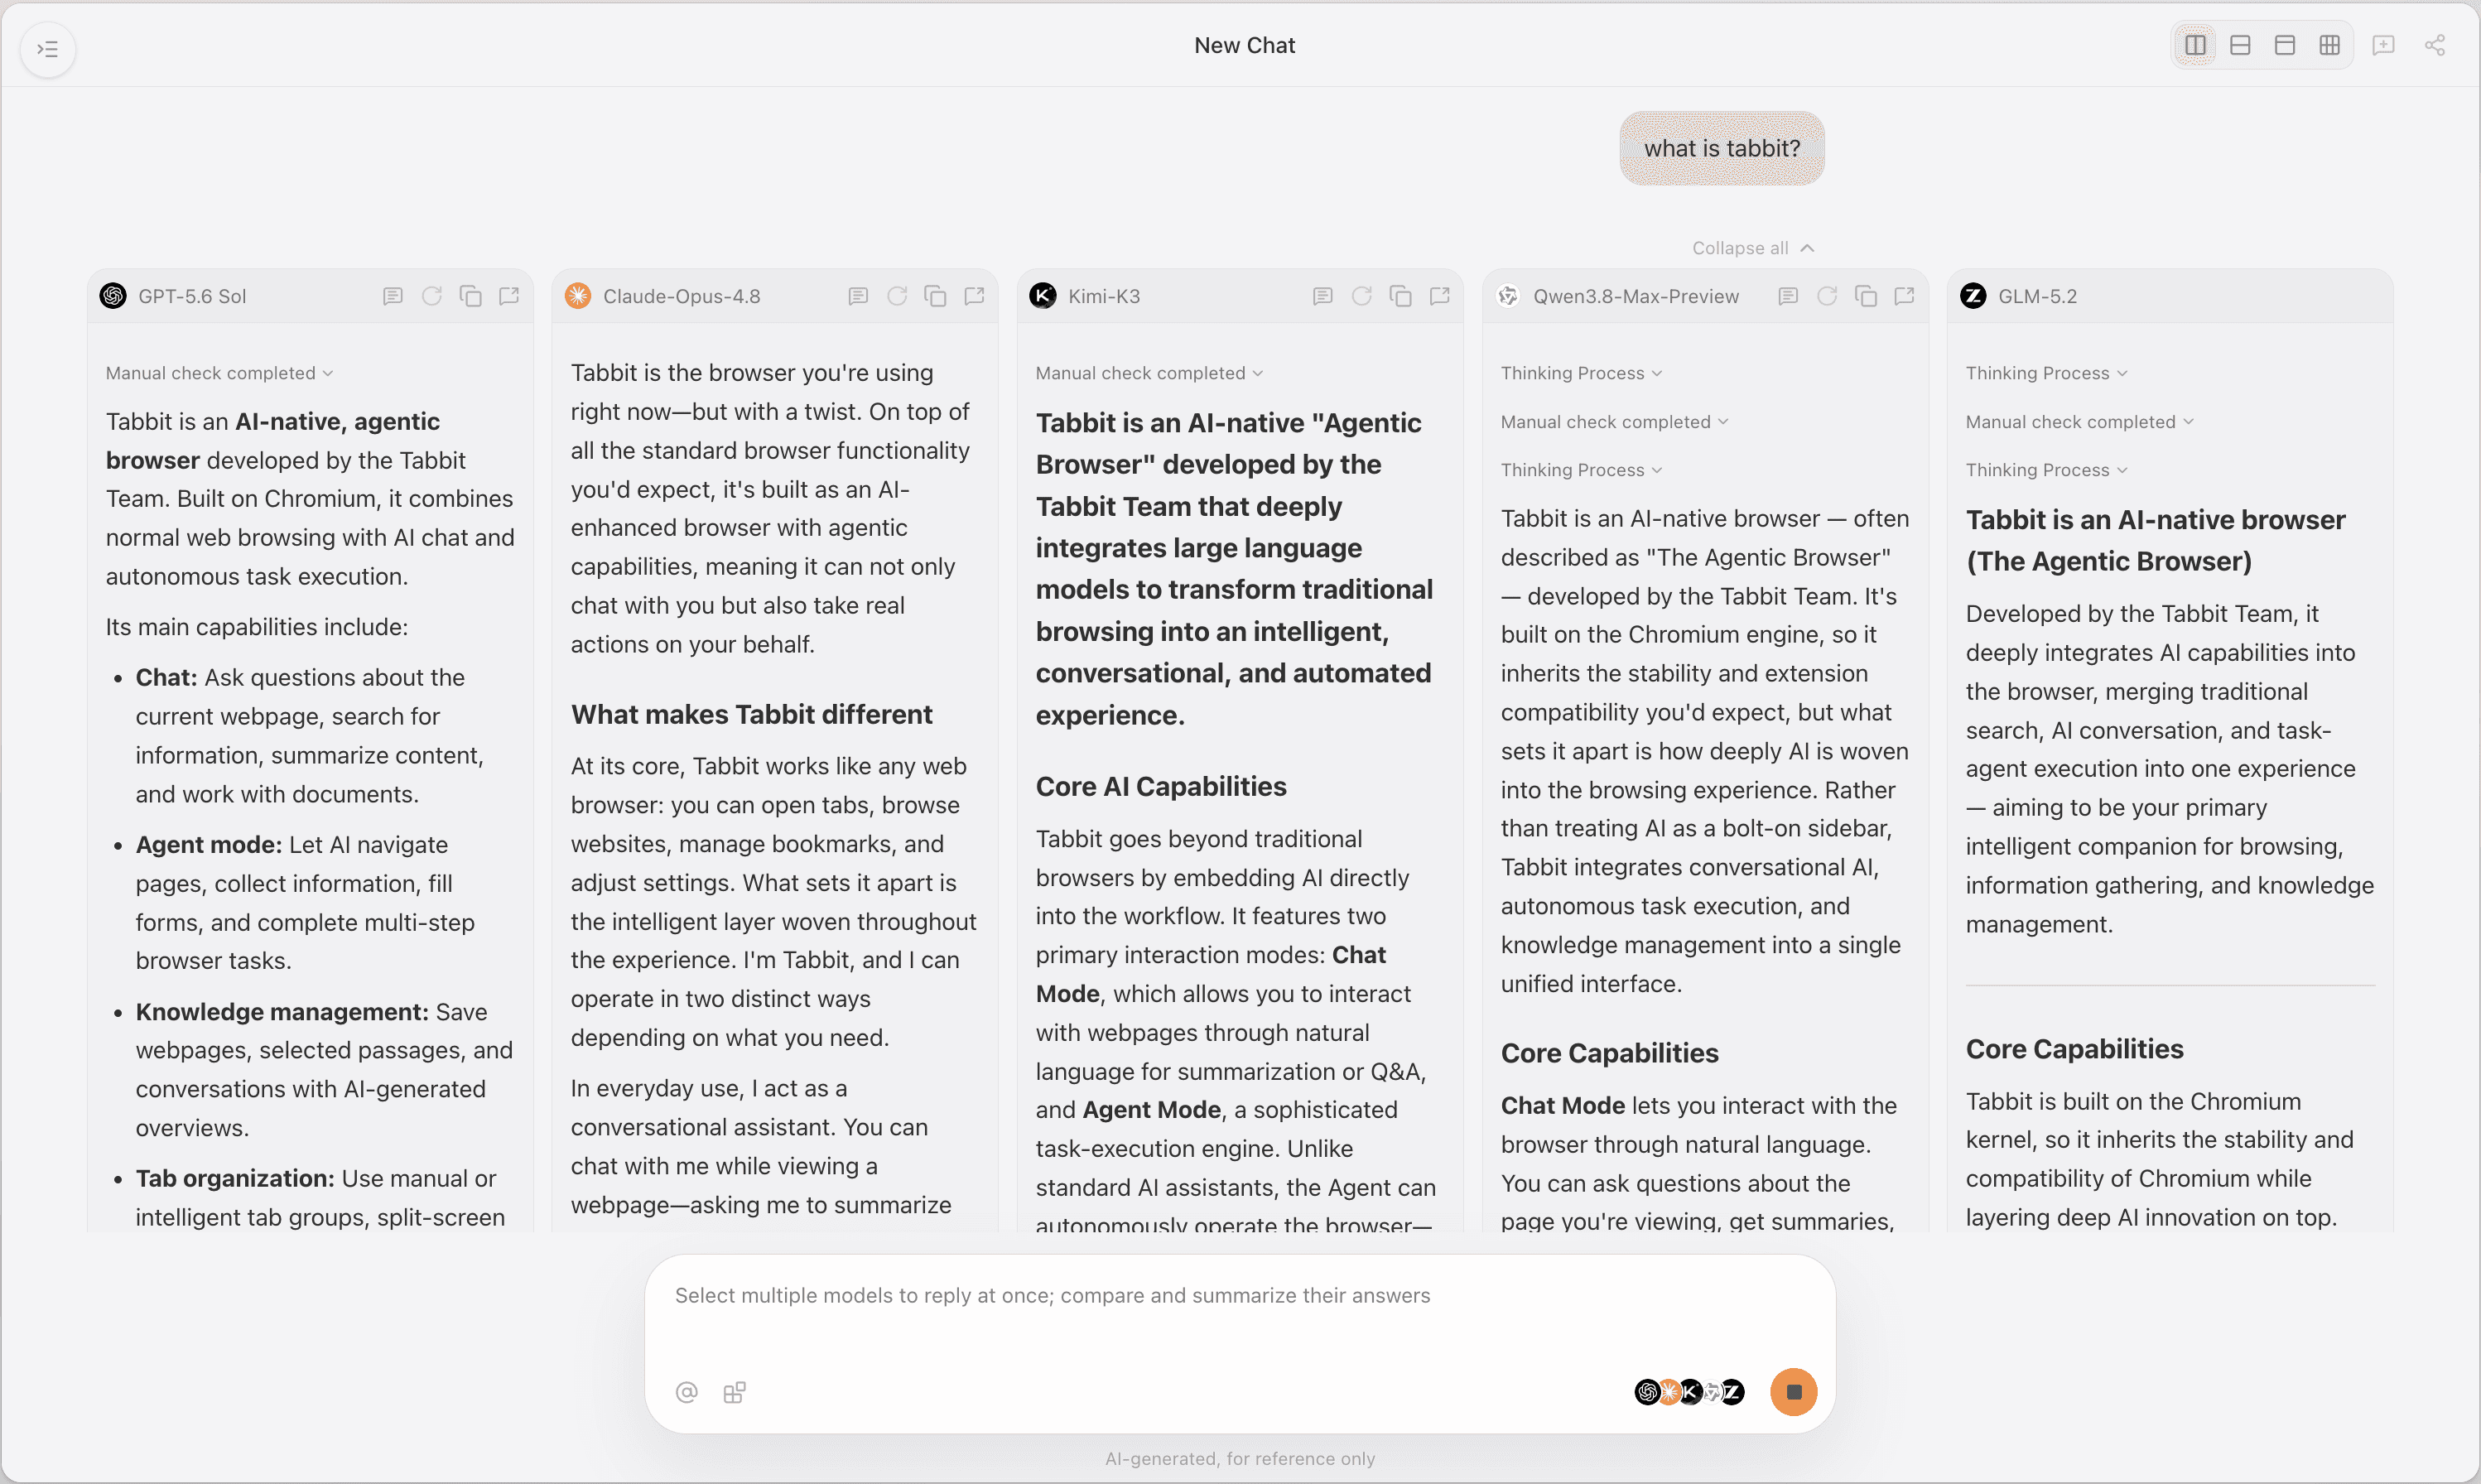
并排查看多个模型的回复有助于比较语气。Tabbit 可以在一个视图中比较当前可用的模型;能否使用仍取决于服务商、模型 ID 和账户权限。Tabbit 与 SillyTavern 是不同产品。
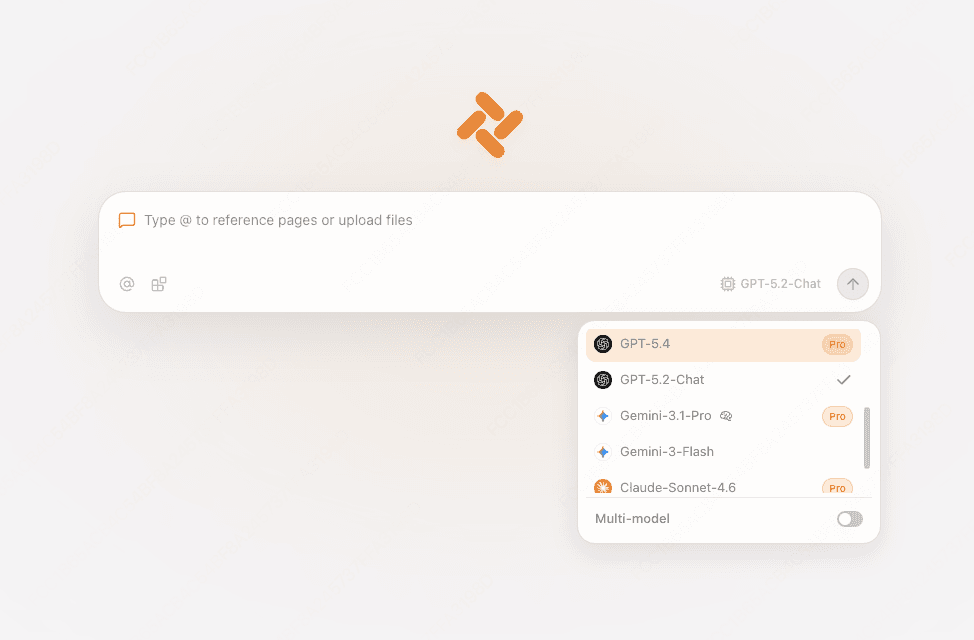
图片展示的是 Tabbit 浏览器,不是 SillyTavern 或本文的实测结果。
常见问题
没有一个模型适用于所有角色卡和后端。可把标注日期的榜单当作候选,再通过自己能访问的服务比较同一场景。
不自带。SillyTavern 是连接推理后端的前端。模型权限、限制、价格、数据处理和内容管理取决于所选服务商或本地服务。
不一定。本文引用的使用榜单只测量其服务网络上的活动,不会单独统计 SillyTavern 用户,也没有在相同设置下测试角色一致性。